知識庫與來源追溯
知識庫是好事道記住你組織資料的地方。理解它怎麼運作,你才知道為什麼 AI 產出的內容可以「找到來源」。
支援的資料型態
- 文件:PDF、Word、試算表、文字檔;
- 圖片:照片與圖像相關資訊;
- 影音:錄音、影片、逐字稿、會議記錄片段;
- 網頁:URL、爬取的網頁內容;
- 資料夾:整理文件用的資料夾,可設定隱私與分享範圍。
資料怎麼被記住
依上傳入口及所選處理方式,好事道可協助完成以下步驟;請以各項處理狀態確認是否已完成:
- 解析文字、圖片或媒體內容;
- 產生摘要、逐字稿與可搜尋的片段;
- 建立索引,讓 AI 之後可以查詢與引用。
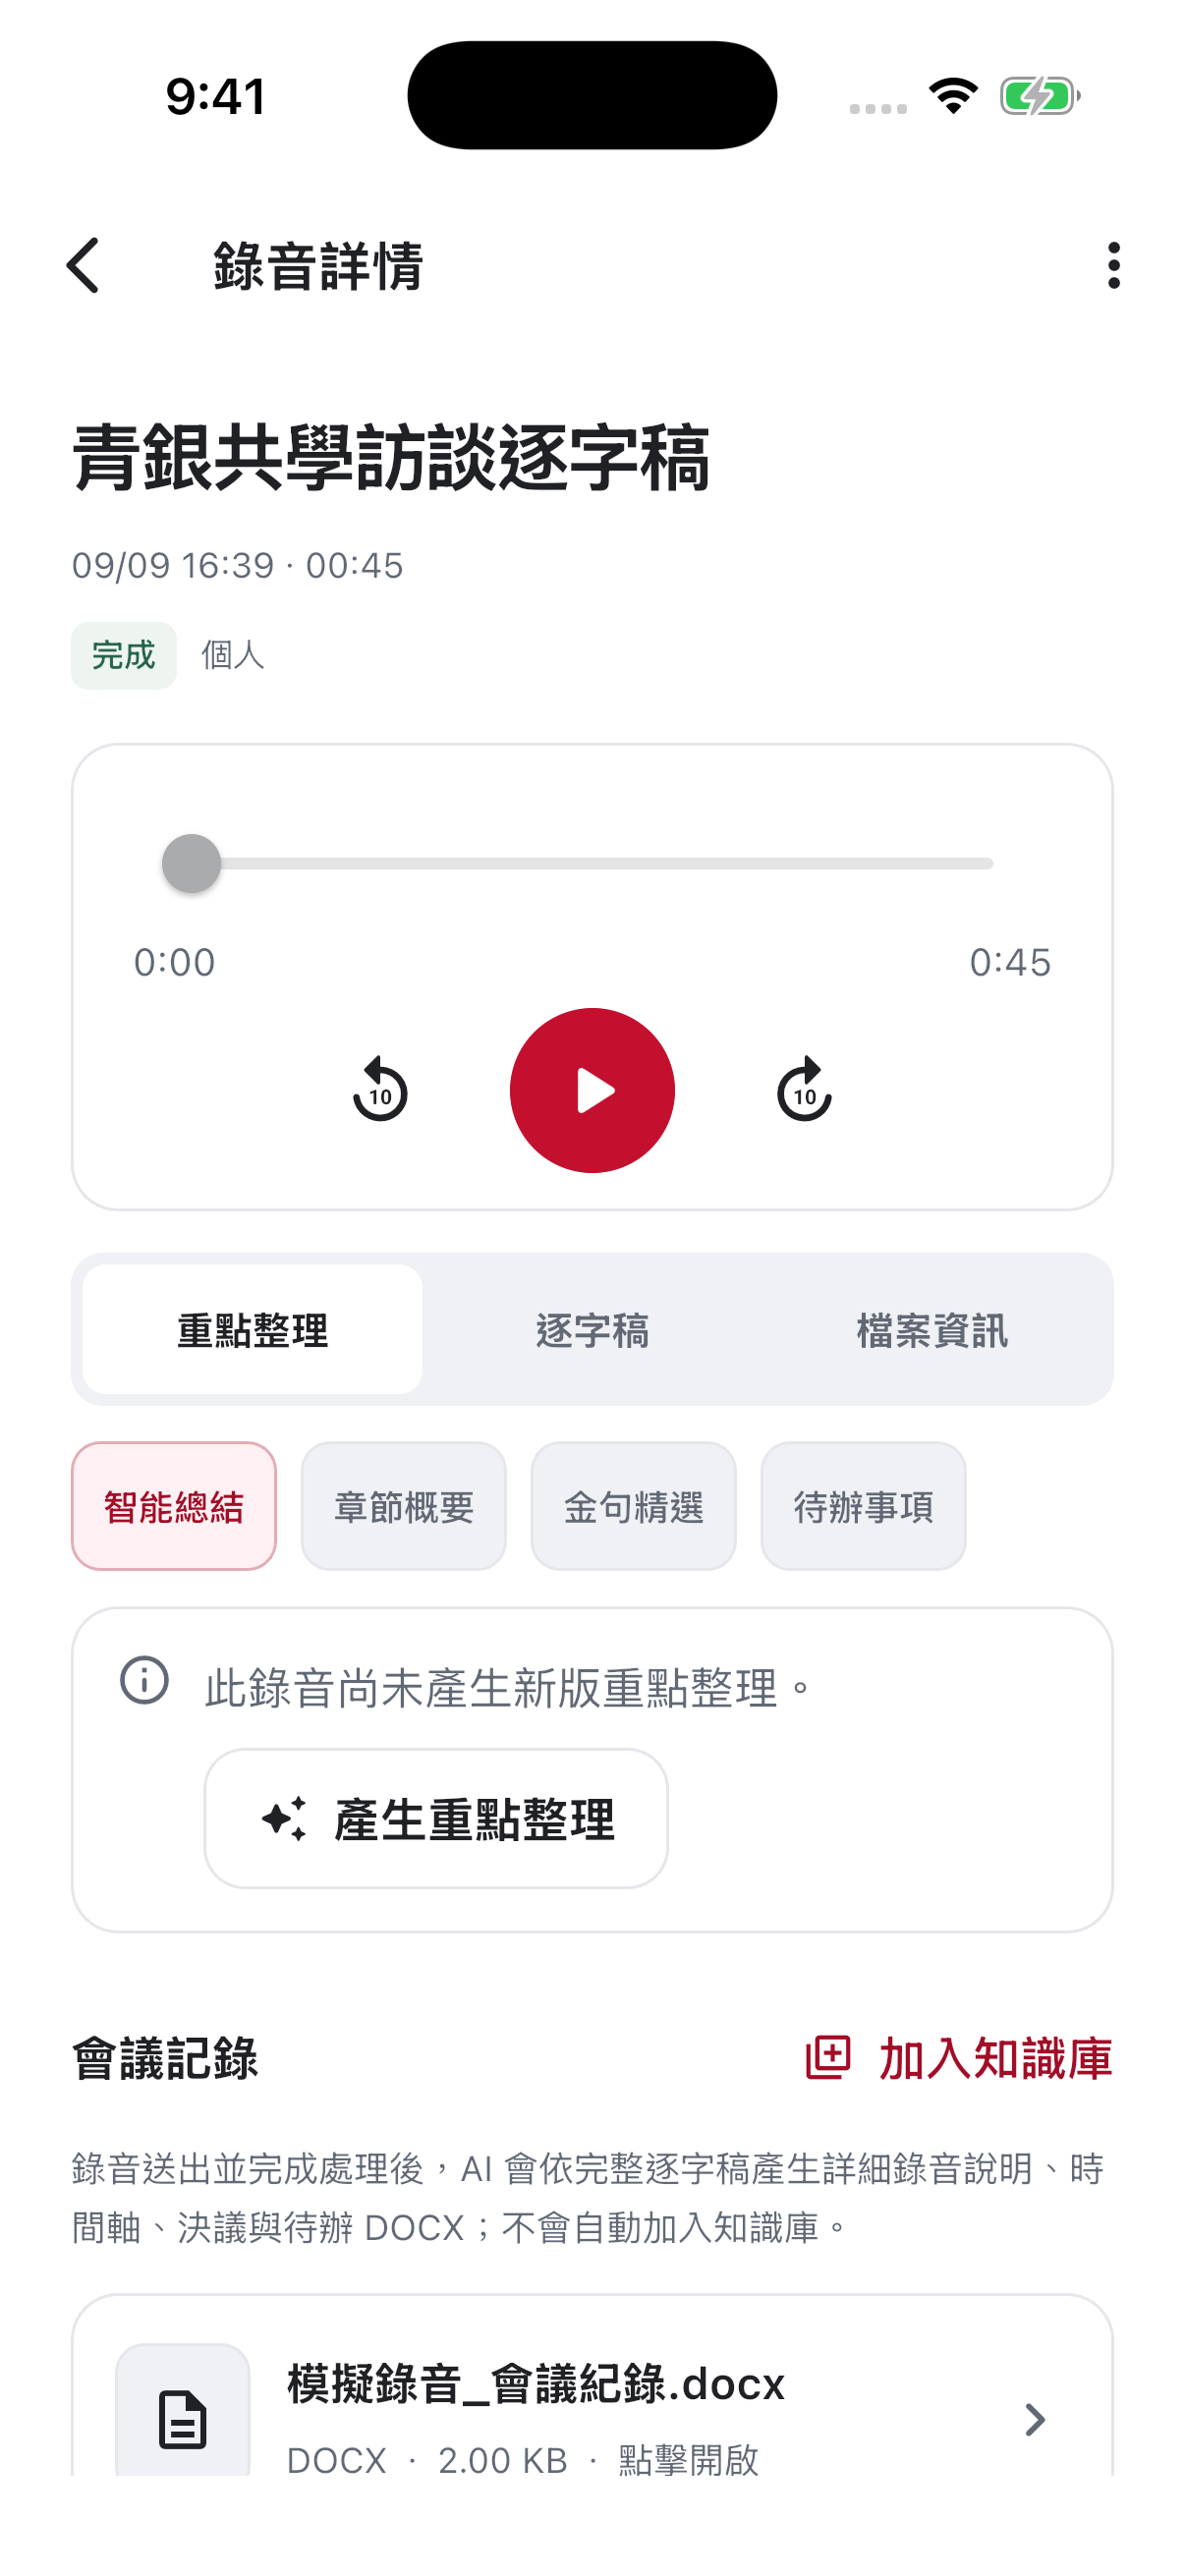
錄音支援重新轉錄與修訂;網頁內容可以保存、分析。
之後怎麼找回「這數字是哪裡來的」
因為所有資料都在同一個知識庫脈絡裡被整理過,AI 產出內容時可以直接引用來源。當你或審閱者想確認某個數字或敘述的出處,可以回到對應的知識庫項目,看到原始文件、照片或逐字稿。
這也是好事道跟單純的 AI 聊天工具最大的不同:不是「AI 說了什麼」,而是「這句話連得回哪一份資料」。
權限與分享:資料屬於誰、誰能看
資料的存取權限依下列範圍限制:
- 擁有者類型(個人、專案、工作空間);
- 工作空間 / 組織範圍;
- 專案範圍;
- 資料夾層級的隱私與分享設定。
AI 不會因為知道某份資料的 ID 就直接讀取——存取一律依照上述授權範圍執行。邀請前仍應核對專案、資料夾與個別分享設定,讓外部協作者取得完成工作所需的範圍。
一個數字需要哪些來源資訊
例如報告寫「完成 120 人次服務」,至少要確認統計期間、計算方式、原始紀錄與重複參與如何處理。人次與不重複人數不能混用。AI 找到一份名單,只代表取得了參考材料,仍要核對它是否支持本次敘述。
文件、解析內容與引用各自代表什麼
保存原始檔案保留了資料本體;解析或轉錄讓文字便於搜尋;引用則把某個結論連回使用的來源。這三者有關係,但不是同一個完成狀態。打開來源時應核對實際內容,而不只看檔名或摘要。
找不到依據時如何處理
先查看檔案處理狀態與權限,再確認本次 AI 工作是否選用了正確資料。若只有推測而沒有足夠來源,將內容標為待確認,請負責人補件。保留缺口比填入看似合理的數字更利於後續交接。
回到原始內容核對
原始資料、摘要、引用與證據的差別
| 名詞 | 意義 | 使用時要注意 |
|---|---|---|
| 原始資料 | 收到或記錄的材料 | 本身仍可能有錯字、缺漏或偏差 |
| 摘要 | 對材料的壓縮與整理 | 可能省略限制或細節,需回查原文 |
| 引用 | 指出敘述使用哪份來源 | 有連結不代表來源支持整句話 |
| 證據 | 能支持特定問題的材料與推理 | 必須對應對象、期間與判斷範圍 |
例如「已決定以無障礙作為選址條件」可由會議紀錄支持;「場地已符合無障礙要求」還需要場地確認材料。兩句話只差幾個字,需要的依據卻不同。
幫下一個人找到正確來源
建議檔名包含主題與日期,資料夾說明則交代適用範圍。若同一份紀錄有修訂,保留修訂原因與採用版本的說明。避免所有檔案都叫「最新版」,因為名稱無法解釋哪些地方改過。
重新整理資料時,先確認是否已有相同來源。重複匯入可能讓 AI 找到多個內容相似但日期不同的版本;這時應在需求裡明確指定本次使用哪一份,不要讓 AI 自行猜測哪個才有效。
核對來源的四個問題
- 這份材料是否談論同一個對象與期間?
- 文字是實際觀察、當事人陳述,還是整理者的推論?
- 原文是否有被摘要省略的條件或例外?
- 本次讀者有權查看原始內容嗎?若不能,如何提供適當的公開說明?
小練習:修正過度推論
原文只有「受訪者希望增加討論時間」,草稿卻寫「活動成效顯著提升」。應改成與原文一致的參與意見,另列出需要後續追蹤的問題。保留來源不是為了增加文件數量,而是讓人能判斷每段話到底說到哪裡。
下一步
了解 AI 怎麼協助你整理這些資料,看 AI 怎麼協作。